СХД для AI: как масштабирование искусственного интеллекта меняет архитектуру хранения данных

Основной источник: Erich Haratsch, Data Storage Innovations for Scalable AI Infrastructure, Marvell, FMS 2026, 4 августа 2026 года. Иллюстрации воспроизводят слайды доклада; источник указан под каждой.
Что такое СХД для AI и зачем она нужна?
СХД для AI — это система хранения данных, обеспечивающая загрузку обучающих данных, сохранение чекпоинтов моделей, хранение KV-кэша и передачу данных между GPU, оперативной памятью и накопителями. В современной AI-инфраструктуре используются локальные NVMe SSD, высокопроизводительные общие хранилища, CXL-память и объектные хранилища S3. Многоуровневая архитектура позволяет уменьшать задержки доступа к данным, сокращать простои GPU и масштабировать обучение и инференс больших языковых моделей.
На FMS 2026 я наткнулся на презентацию Эриха Харатша, Senior Distinguished Engineer в Marvell, с названием: Data Storage Innovations for Scalable AI Infrastructure. Доклад целиком посвящен тому, как меняется архитектура хранения данных по мере того, как AI выходит за рамки обычного обучения и превращается в огромную инфраструктуру для reasoning, агентного AI и инференса с длинным контекстом.
«AI scaling is fundamentally a storage problem».
Мне кажется, это очень точная формулировка того, что сейчас происходит с инфраструктурой AI. Несколько лет мы обсуждали практически исключительно GPU. Потом выяснилось, что GPU недостаточно, нужна сеть. Затем понадобилась HBM. А теперь становится понятно, что и этого недостаточно.
Вокруг GPU возникает огромный объем данных, который нужно постоянно загружать, выгружать, сохранять, восстанавливать и передавать между уровнями инфраструктуры. В результате СХД из системы, где просто лежат обучающие датасеты, постепенно превращается в активную часть вычислительного конвейера AI.
Почему AI внезапно начал потреблять столько хранилища
Почему AI требует всё больше хранилища: данные, reasoning и агентный AI
Харатш начинает с довольно очевидного наблюдения: за несколько лет AI прошел путь от генеративного AI к reasoning, затем к агентному AI, physical AI и локальному AI. Но для инфраструктуры важна не столько смена названий, сколько изменение характера вычислений.
В классическом генеративном AI мы в основном имели одношаговый инференс. Reasoning означает уже многошаговый инференс. Агентный AI добавляет множество взаимодействующих агентов. Physical AI приносит модели мира. А локальный AI начинает распределять инференс между дата-центром, периферией и конечными устройствами.
Особенно важно первое изменение. Reasoning и агентный AI резко увеличивают число генерируемых токенов. Инференс перестает быть коротким запросом «промпт → ответ». Теперь это скорее «промпт → рассуждение → вызов инструмента → результат → рассуждение → еще один вызов → другая модель → финальный ответ».
Каждый такой цикл означает дополнительный контекст, дополнительный KV-кэш и дополнительное перемещение данных. Поэтому узкое место постепенно смещается. Мы все еще ограничены количеством FLOPS, но все чаще система упирается в то, насколько быстро она способна подать данные вычислителю и убрать их оттуда.
Сколько места занимают AI-модели и обучающие датасеты
В презентации есть хороший парадокс. Если посмотреть непосредственно на размеры состояния модели и обучающего датасета, цифры огромные в человеческом масштабе, но далеко не фантастические для современной инфраструктуры хранения.
Например, Marvell приводит оценки примерно следующего порядка: GPT-3 около 1,4 ТБ состояния модели, Llama 3 405B порядка 3,2 ТБ, а для гипотетической модели фронтирного класса на 1,6 трлн параметров около 12,8 ТБ. Обучающий датасет при этом может составлять десятки петабайт.
Разумеется, часть цифр в таблице относится к оценкам, а не к официальным спецификациям моделей, и сама презентация это отмечает. Поэтому я бы смотрел на них именно как на упражнение по оценке размеров, а не как на точные характеристики конкретных LLM.
Но порядок величин действительно интересный. 12 ТБ вообще не проблема для СХД. Даже 100 ТБ не проблема. Проблема возникает, когда эти данные нужно использовать тысячам GPU одновременно. И вот тогда емкость превращается в проблему пропускной способности.
Чекпоинтинг AI-моделей: как обучение увеличивает нагрузку на СХД
Особенно хорошо это видно на чекпоинтинге. Большие модели обучаются неделями или месяцами. Потерять несколько часов вычислений из-за отказа узла при стоимости современного кластера GPU чрезвычайно дорого. Поэтому состояние обучения регулярно сохраняется.
Marvell приводит показательный расчет: для модели порядка 1,6 трлн параметров, 30-дневного обучения и чекпоинта каждые 30 минут общий объем временных данных чекпоинтов может превысить 50 ПБ, хотя постоянный датасет в конечном счете может составлять около 200 ТБ. Предлагаемый путь данных выглядит так: GPU → NVMe → параллельная файловая система → объектное хранилище.
На мой взгляд, это один из самых важных слайдов презентации. Мы часто оцениваем СХД для AI по емкости: «Мне нужно хранить 100 ТБ модели и несколько петабайт датасета». Но СХД должна быть рассчитана совсем на другое число: сколько данных через нее пройдет за время жизни нагрузки? И оно может быть на порядки больше объема данных, который физически находится на дисках в каждый конкретный момент.
Индустрия уже сталкивается с этой проблемой на практике. PyTorch Distributed Checkpoint сохраняет части модели параллельно с нескольких ранков и поддерживает перешардирование при восстановлении на кластере другой конфигурации. В экспериментах Meta и Crusoe на 1856 GPU асинхронный чекпоинтинг сократил фоновую обработку одного чекпоинта примерно с 436 до 67 секунд. В другом эксперименте PyTorch и IBM асинхронный чекпоинтинг снизил фактический простой обучения для модели 7B примерно со 149 до 6 секунд.
То есть чекпоинтинг это уже не «резервная копия модели». Это отдельная высокопроизводительная нагрузка на СХД.
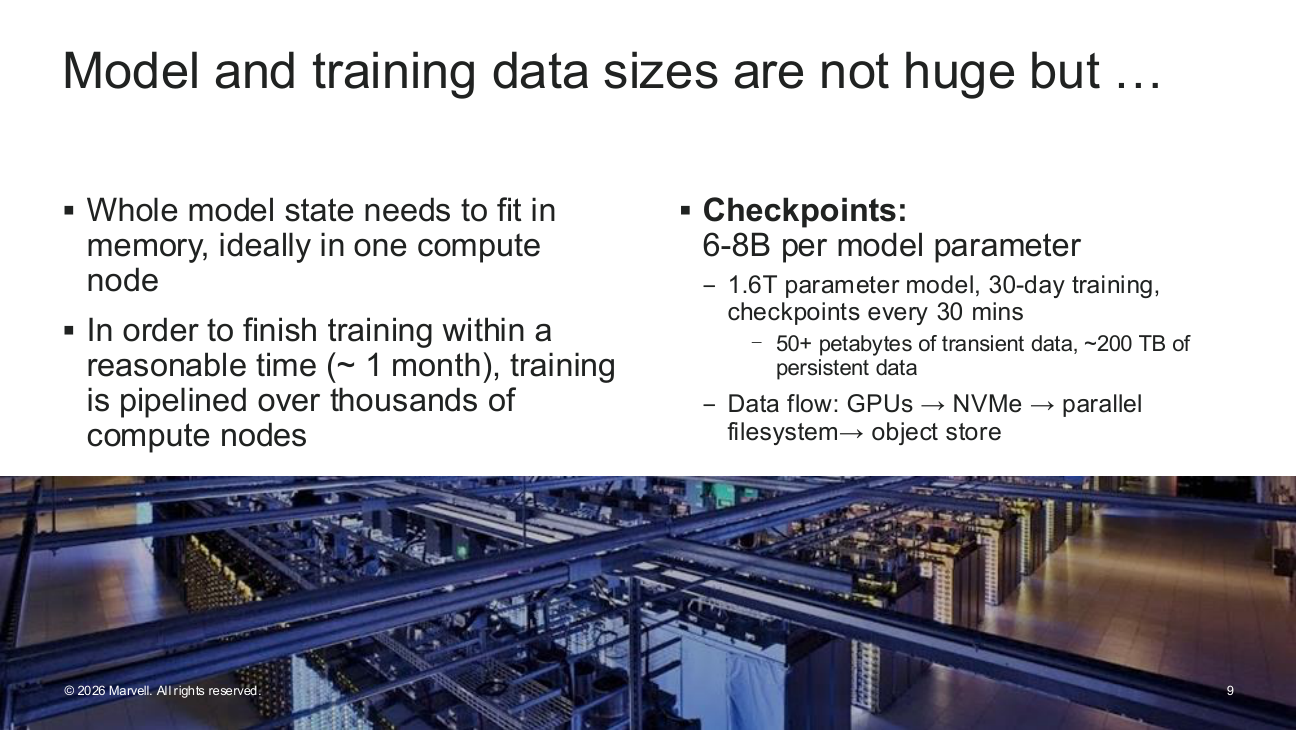
Слайд 9. Чекпоинтинг как отдельная высокопроизводительная нагрузка на СХД. Источник: Marvell, FMS 2026.
Инференс AI и KV-кэш: новые требования к хранению данных
При обучении СХД в основном должна обеспечивать огромную пропускную способность. Инференс приносит совершенно другую задачу. Помимо весов модели появляется KV-кэш.
В упрощенном виде память инференса выглядит как веса модели плюс KV-кэш. Причем KV-кэш зависит от количества пользователей, глубины модели, размера скрытого слоя, длины контекста и точности.
И здесь возникает крайне неприятное свойство. Веса модели относительно статичны. А KV-кэш растет практически вместе с контекстом. Marvell приводит пример, где для одного пользователя модель с длинным контекстом может создавать десятки или даже сотни гигабайт KV-кэша.
Теперь умножим это не на одного пользователя, а на тысячи параллельных сессий. HBM перестает быть просто памятью модели. Она превращается в самый дорогой уровень кэша в мире. И становится совершенно очевидно, что хранить в HBM весь контекст всех пользователей невозможно.
NVMe для AI: как SSD становятся расширением памяти GPU
Это, пожалуй, самое интересное изменение во всей архитектуре СХД для AI. Мы привыкли думать об иерархии примерно так: HBM → DRAM → SSD → HDD → лента. Каждый следующий слой медленнее, дешевле и больше.
Но инференс превращает NVMe в нечто намного более близкое к расширению памяти. KV-кэш, который не помещается в HBM GPU, можно выгрузить сначала в память хоста, затем на локальные NVMe, затем в общую СХД на NVMe.
И это уже реально работающая архитектура. Например, LMCache сегодня поддерживает выгрузку KV-кэша из GPU в RAM CPU и на локальные накопители. Более того, при нескольких NVMe можно распределять кэш по отдельным путям для разных GPU, желательно с учетом топологии PCIe и NUMA. Есть и бэкенд GDS, позволяющий работать с хранилищем через GPUDirect Storage и тем самым организовать прямой путь между памятью GPU и накопителем.
Получается очень интересная иерархия: HBM → DRAM → локальные NVMe → удаленные высокопроизводительные NVMe → емкостное хранилище. И KV-кэш начинает мигрировать между этими слоями примерно так же, как страницы памяти когда-то мигрировали между RAM и swap. Только пропускная способность теперь измеряется десятками и сотнями гигабайт в секунду.
AI Factory: пятиуровневая архитектура хранения данных в дата-центре
На мой взгляд, главный слайд Харатша даже не про чекпоинтинг и не про KV-кэш. Это пятиуровневая иерархия хранения ЦОД для AI. Marvell предлагает рассматривать хранение практически симметрично иерархии вычислений.
Первый уровень: Tray. Несколько локальных SSD E1.S, примерно десятки терабайт. Для обучения это временный scratch, а для инференса максимально горячий KV-кэш, уже не помещающийся в HBM или LPDDR.
Следующий уровень: Rack. Уже сотни терабайт локальных NVMe. Это агрегированный scratch для обучения и KV-кэш в пределах стойки.
Третий уровень: Pod. Здесь появляется полноценный all-flash уровень на NVMe-oF емкостью порядка 10–40 ПБ. Он должен подавать подготовленные данные GPU, принимать параллельные чекпоинты, а для инференса содержать теплый KV-кэш и быстрые векторные БД для RAG.
Четвертый уровень: Cluster. Масштабируемая корпоративная СХД на NFS, на flash или гибридных носителях. Емкость 100 ПБ и выше. Для обучения это уровень промежуточного хранения, для инференса холодный KV-кэш и телеметрия.
Наконец, пятый уровень: Campus. Объектное хранилище S3 на HDD и лентах, уже на уровне эксабайтов. Здесь находится озеро данных и долгосрочное хранение обучающих и сгенерированных датасетов.
Мне эта схема кажется крайне правильной, потому что она наконец перестает противопоставлять локальное и общее хранение. Для AI нужны оба. Причем одновременно.
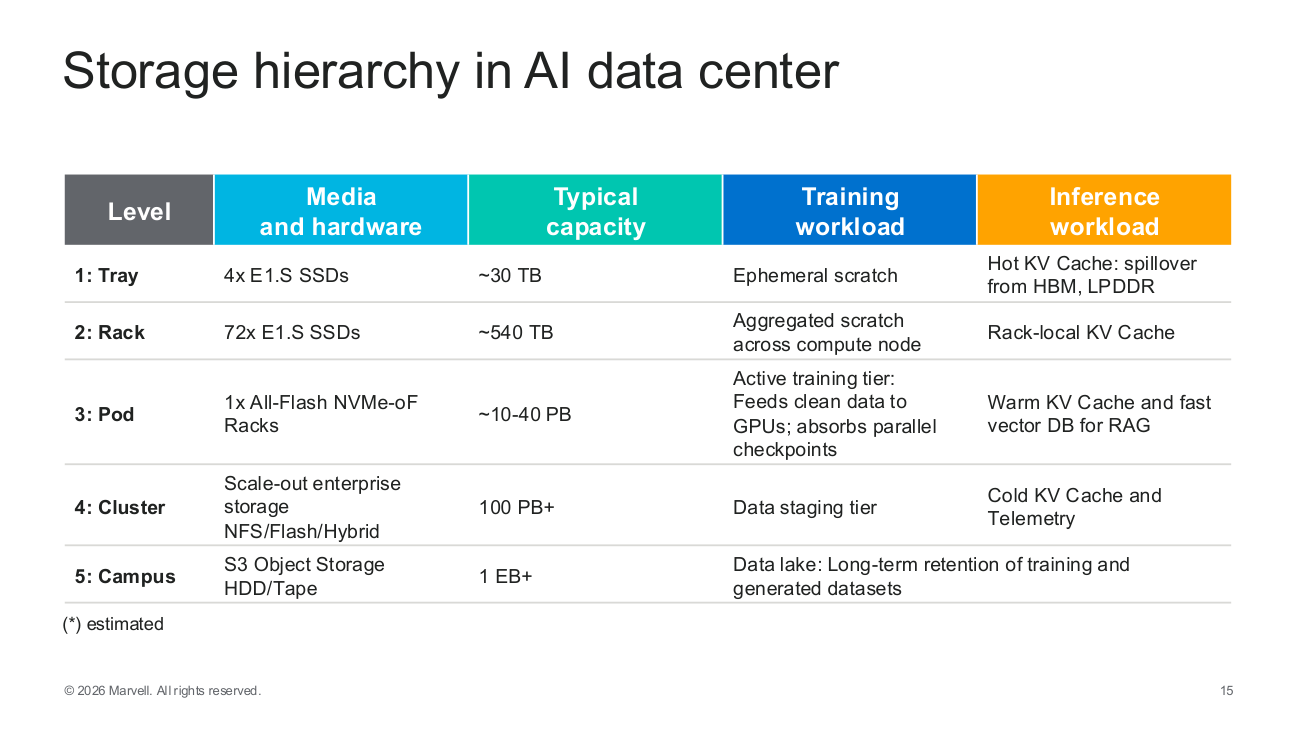
Слайд 15. Пятиуровневая иерархия хранения ЦОД для AI. Источник: Marvell, FMS 2026.
Локальные NVMe или общая СХД: что выбрать для AI-инфраструктуры
В инфраструктуре AI постоянно возникает спор: зачем мне дорогая общая СХД, если у каждого сервера с GPU можно поставить несколько быстрых NVMe?
Ответ: потому что локальные NVMe действительно великолепны, пока данные нужны только этому серверу. Как только появляются чекпоинты, которые должны пережить вычислительный узел; KV-кэш, который желательно переиспользовать между экземплярами инференса; дезагрегированные prefill и decode; общая векторная БД; задача обучения, которая может продолжиться на другом наборе GPU; нагрузки Kubernetes, которые физически перемещаются между узлами, локальный SSD перестает быть достаточным.
Именно поэтому я бы не рассматривал локальное и удаленное хранение как конкурирующие архитектуры. Локальные NVMe это кэш L1/L2 около GPU. Удаленная производительная СХД это общий рабочий набор. Объектное хранилище это долговременное озеро данных.
Примерно такую же картину мы сейчас видим и в реальных фреймворках инференса. LMCache прямо реализует многоуровневый KV-кэш между GPU, CPU, локальными накопителями и удаленными бэкендами.
GPU-центричная СХД: как ускорить передачу данных между GPU и хранилищем
И здесь начинается следующая интересная трансформация. Классическая сетевая СХД создавалась вокруг CPU. Приложение вызывает файловый API, ядро обрабатывает ввод-вывод, данные проходят через память CPU, сетевой стек и дальше уходят в хранилище.
Для кластера GPU все это становится лишней работой. NVIDIA GPUDirect Storage позволяет создать прямой DMA-путь между памятью GPU и хранилищем, минуя промежуточный буфер в памяти хоста.
Но индустрия пошла еще дальше. В презентации Marvell среди соединений с удаленной СХД указаны не только NVMe/RDMA и NVMe/TCP, но также S3 поверх RDMA и NFS. Еще несколько лет назад S3 выглядел бы здесь довольно странно. Объектное хранилище традиционно было емкостным уровнем: дешево, масштабируемо, но относительно медленно. Это уже меняется.
S3 и RDMA: высокопроизводительное объектное хранилище для AI
В 2025–2026 годах NVIDIA фактически начала превращать S3 из чисто емкостного протокола в интерфейс высокопроизводительной СХД для AI. В архитектуре S3 поверх RDMA путь управления остается совместимым с S3, а полезная нагрузка передается по RDMA, что снимает значительную часть накладных расходов TCP и CPU.
К 2026 году NVIDIA уже документирует cuObject, библиотеку для прямой передачи данных между памятью GPU или системной памятью и S3-совместимым объектным хранилищем по RDMA.
Мне кажется, это довольно фундаментальный сдвиг. Исторически существовал компромисс: хочешь производительность, бери параллельную файловую систему; хочешь масштаб и простоту пространства имен, бери объектное хранилище. Если S3 действительно получает плоскость данных на RDMA и прямой путь к GPU, граница между этими двумя мирами становится гораздо менее очевидной.
KV-кэш для AI-инференса: повторное использование контекста и ускорение вычислений
Возьмем агентный инференс. Пользователь загружает огромный документ или кодовую базу. Модель выполняет prefill и строит большой KV-кэш. Если следующий запрос приходит на другой GPU и кэша там нет, GPU вынужден снова выполнить prefill. То есть мы повторно покупаем уже сделанную вычислительную работу.
Гораздо логичнее сохранить KV-кэш и при следующем запросе загрузить его обратно. Именно здесь СХД начинает конкурировать не с SSD. Она начинает конкурировать с повторными вычислениями на GPU. И это совершенно другая экономика.
VAST уже экспериментирует с общим персистентным KV-кэшем и прямо описывает СХД как часть инфраструктуры контекста инференса. LMCache делает то же на уровне открытого middleware: KV-кэш можно выгружать и затем переиспользовать между запросами и экземплярами инференса, уменьшая повторный prefill и время до первого токена.
То есть схема Marvell это уже далеко не футурология. Мы фактически наблюдаем появление нового класса нагрузки на СХД: хранение контекста инференса.
Хранение данных для AI: различия между обучением, инференсом и архивом
Здесь становится понятна еще одна центральная мысль презентации: универсальная СХД «на все случаи» больше не работает.
В конвейере AI совершенно разные профили ввода-вывода. Подготовка данных: петабайтный масштаб, преимущественно ориентация на пропускную способность. Обучение: огромная параллельная пропускная способность и чекпоинты. Инференс: чувствительная к задержкам загрузка модели, RAG и KV-кэш. Архив: снова петабайты и эксабайты и преимущественно последовательная емкостная нагрузка.
Особенно инференс приносит неожиданную вещь: мелкий ввод-вывод. И это уже начинает влиять непосредственно на конструкцию SSD.
SSD для AI: классы Performance, Capacity и Small I/O
На одном из последних слайдов flash разбивается на три совершенно разных класса.
Первый: Performance Tier. Оптимизация под 4K и последовательную производительность, локальные или удаленные производительные уровни, TLC/QLC, E1.S и E3.S.
Второй: Capacity Tier. Главное здесь емкость и производительность чтения. QLC и nearline flash, большие форм-факторы вроде E1.L, E3.L и нового E2. Marvell говорит уже о перспективах емкости, приближающейся к петабайту на устройство.
И наконец третий класс: Small I/O Tier. Оптимизация начинается примерно с 512-байтовых операций. Эти SSD предназначены уже непосредственно для GPU-центричных нагрузок и могут использовать NAND с низкой задержкой или pseudo-SLC.
Мне этот третий класс кажется особенно интересным. SSD для AI больше не обязательно должен быть просто максимально быстрым SSD. Нужен SSD, оптимизированный под конкретную функцию внутри иерархии памяти и хранения. И это совершенно другая постановка задачи.
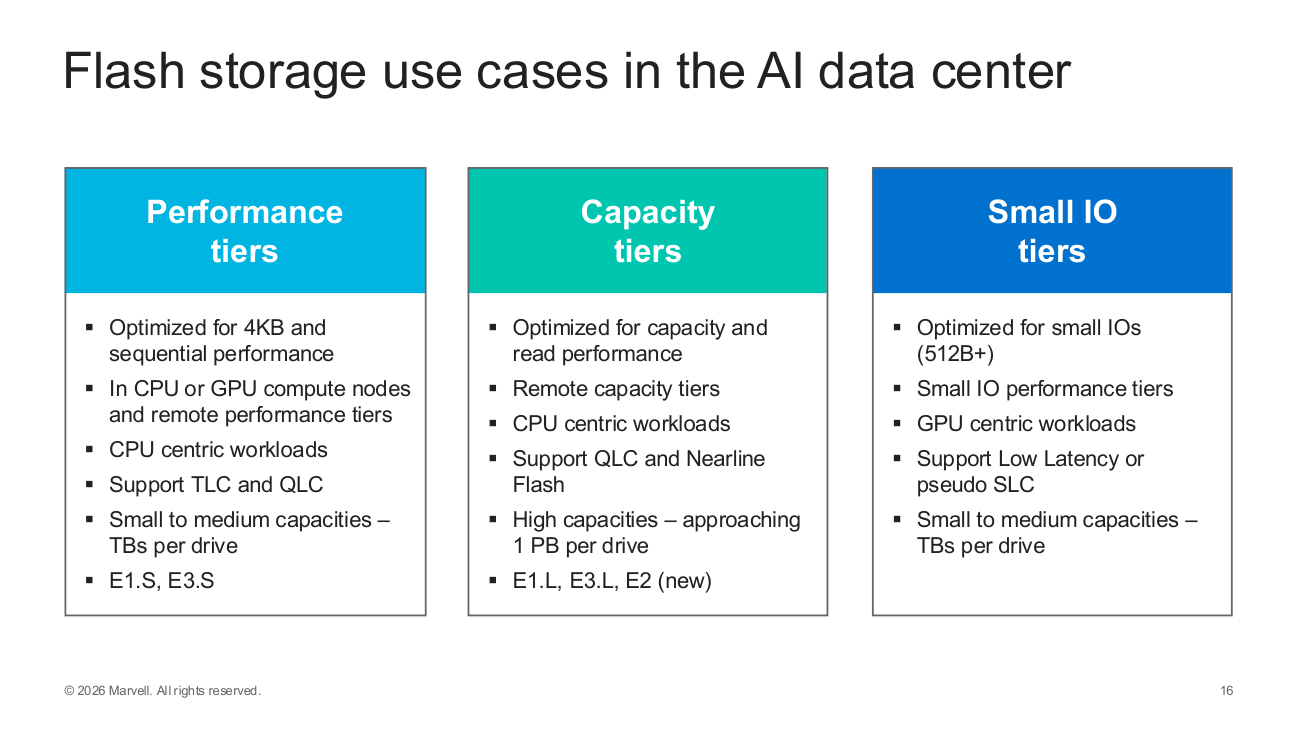
Слайд 16. Performance, Capacity и Small I/O tiers для ЦОД AI. Источник: Marvell, FMS 2026.
PCIe 6.0 и NVMe SSD: ускорение хранения данных для AI
На FMS 2026 Marvell одновременно анонсировала Bravera SC6, контроллер для NVMe SSD с PCIe 6.0. Он поддерживает NVMe 2.2, высокоскоростную NAND и использует 15 встроенных ядер Arm для параллельной обработки задач управления накопителем. Образцы ожидаются в четвертом квартале 2026 года.
Интересно здесь не столько удвоение скорости PCIe. В узле AI SSD физически становится частью пути данных GPU. Чем быстрее GPU, тем дороже каждая миллисекунда, в течение которой он ждет данные.
Поэтому стоимость хранения все меньше определяется ценой самого SSD и все больше ценой простаивающего GPU. Именно поэтому $/TB перестает быть единственной разумной метрикой СХД для AI. Нужны уже GB/s на GPU, IOPS на GPU, время завершения чекпоинта, задержка восстановления KV-кэша, влияние на время до первого токена и, в конечном счете, утилизация GPU.
CXL и DRAM: расширение памяти для AI-инференса и KV-кэша
Хотя презентация в первую очередь посвящена хранению, вокруг нее хорошо видно еще одно изменение: расширяется сама иерархия памяти.
Marvell активно развивает CXL. Structera X используется для расширения памяти, Structera A добавляет вычисления рядом с памятью, а Structera S позволяет строить общие пулы памяти на уровне стойки. У нового Structera S 30260 заявлено до 48 ТБ общей памяти и до 4 ТБ/с суммарной пропускной способности.
А в совместной работе Marvell и SK hynix память CXL уже рассматривается именно как место для переполнения KV-кэша при инференсе с длинным контекстом: данные KV переносятся из ограниченной HBM в большой пул памяти CXL, а часть операций выполняется непосредственно рядом с этой памятью.
То есть иерархия AI постепенно превращается в HBM → CXL/DRAM → локальные NVMe → удаленные NVMe → емкостной flash → HDD → лента. И каждый слой оптимизируется не просто под емкость или задержку. Он получает свою функцию в AI.
Как меняется архитектура хранения данных в AI-инфраструктуре
Раньше СХД проектировалась вокруг приложений. Теперь ее приходится проектировать вокруг жизненного цикла данных внутри конвейера AI.
Датасет нужно быстро подать на обучение. Чекпоинт быстро принять от тысячи GPU. Веса модели максимально быстро раздать вычислительным узлам. KV-кэш сохранить, найти, переиспользовать и желательно передать непосредственно GPU. Для RAG обеспечить высокую скорость мелкого случайного доступа. Сгенерированные данные сохранить. Старые обучающие данные переместить на емкостной уровень. И все это происходит одновременно.
Поэтому архитектура хранения AI Factory начинает удивительно напоминать иерархию памяти процессора. Есть крошечная и безумно дорогая HBM. Есть DRAM/CXL. Есть локальные NVMe. Есть общий flash. Есть емкостной flash. Есть объектное хранилище. Есть HDD и лента. И между всеми этими уровнями должно существовать эффективное перемещение данных.
Будущее СХД для AI: интеграция вычислений, памяти, сети и хранения
В конце презентации Харатш формулирует четыре вывода. Параметры моделей, количество токенов, чекпоинты и KV-кэш растут на порядки. Универсальная архитектура хранения перестает работать. Flash и NVMe становятся фундаментом движения данных внутри инфраструктуры AI. А масштабируемый AI требует совместного проектирования вычислений, памяти, сети и хранения.
Я бы добавил к этому только одну мысль. СХД постепенно перестает быть периферией системы AI.
Если раньше архитектуру кластера AI можно было условно нарисовать как «кластер GPU → сеть → СХД», то сейчас это уже неправильно. Хранение находится внутри самого вычислительного конвейера: GPU ↔ HBM ↔ память ↔ локальные NVMe ↔ общие NVMe ↔ объектное хранилище.
А такие механизмы, как GPUDirect Storage, cuObject и S3 поверх RDMA, NVMe-oF и выгрузка KV-кэша, постепенно стирают границу между подсистемой памяти и подсистемой хранения.
И, пожалуй, именно это я считаю главным выводом из презентации. Следующая большая битва в инфраструктуре AI будет идти не только за более быстрые GPU. Она будет идти за то, как максимально дешево и быстро удерживать нужные данные рядом с GPU и перемещать их между уровнями системы ровно в тот момент, когда они нужны.
Потому что GPU, который ждет данные, это просто очень дорогой обогреватель. А СХД, которая способна держать GPU постоянно занятым, становится уже не вспомогательной инфраструктурой. Она становится частью вычислительной машины.
FAQ
Что такое СХД для AI?
СХД для AI — это инфраструктура хранения, обеспечивающая доступ к датасетам, весам моделей, чекпоинтам и KV-кэшу во время обучения и инференса.
Почему GPU-кластерам нужна высокопроизводительная СХД?
GPU-кластеры обрабатывают большие объемы данных параллельно. Недостаточная пропускная способность хранилища и высокие задержки могут увеличивать время выполнения задач и снижать утилизацию GPU.
Зачем AI-инференсу NVMe SSD?
NVMe SSD обеспечивают быстрый доступ к весам моделей и позволяют хранить часть KV-кэша за пределами ограниченной памяти GPU. Эффект зависит от нагрузки и конфигурации системы.
Что такое пятиуровневая архитектура хранения AI Factory?
Это подход к организации хранения на уровнях сервера, стойки, вычислительного pod, кластера и кампуса. Уровни различаются по задержкам, пропускной способности, емкости и назначению.
Что такое GPUDirect Storage?
GPUDirect Storage — технология NVIDIA, позволяющая организовать прямой путь передачи данных между памятью GPU и поддерживаемыми системами хранения, сокращая промежуточное копирование через память CPU.
Как выбрать СХД для AI-инфраструктуры?При выборе СХД для AI необходимо учитывать не только емкость, но и пропускную способность, задержки, параллелизм операций ввода-вывода и характер рабочей нагрузки. Для обучения критичны скорость чтения датасетов и сохранения чекпоинтов. Для инференса важны доступ к весам модели, повторное использование KV-кэша и скорость обработки запросов. Для долгосрочного хранения подходят масштабируемые объектные системы. Оптимальная архитектура сочетает локальные NVMe, общую высокопроизводительную СХД и емкостное хранилище.
Как выбрать хранилище для обучения и инференса AI?
Для обучения оценивают параллельное чтение данных и производительность чекпоинтинга. Для инференса — задержки, загрузку весов, доступ к KV-кэшу и профиль мелких операций ввода-вывода. Для архивов приоритетны емкость и стоимость хранения.
Что такое KV-кэш и зачем хранить его на SSD?
KV-кэш — это набор ключей и значений внимания, который языковая модель использует для повторного обращения к предыдущим токенам контекста. При длинных контекстах и большом количестве параллельных сессий его объем может существенно увеличиваться. Перенос менее востребованных данных KV-кэша в DRAM, CXL-память или NVMe позволяет эффективнее использовать ограниченную память GPU. Повторное использование сохраненного кэша при подходящих условиях также может сократить необходимость повторного вычисления контекста.
Локальные NVMe SSD обеспечивают быстрый доступ к данным непосредственно на сервере с GPU и подходят для временных файлов и горячего кэша. Общая СХД позволяет совместно использовать данные между вычислительными узлами, сохранять чекпоинты независимо от жизненного цикла сервера и организовывать централизованное хранение. Объектное хранилище предназначено преимущественно для масштабируемого хранения датасетов, архивов и других долговременных данных. Эти уровни дополняют друг друга и решают разные задачи AI-инфраструктуры.
Источники и материалы для дальнейшего чтения
1. Marvell, FMS 2026: https://www.marvell.com/company/events/fms-2026.html
2. NVIDIA GPUDirect Storage: https://docs.nvidia.com/gpudirect-storage/
3. Документация LMCache: https://docs.lmcache.ai/
4. LMCache: бэкенд локального хранения: https://docs.lmcache.ai/kv_cache/storage_backends/local_storage.html
5. LMCache: бэкенд GDS: https://docs.lmcache.ai/kv_cache/storage_backends/gds.html
6. PyTorch: Distributed Checkpoint: https://docs.pytorch.org/tutorials/recipes/distributed_checkpoint_recipe.html
7. PyTorch: 6x Faster Async Checkpointing: https://pytorch.org/blog/6x-faster-async-checkpointing/
8. PyTorch: Reducing Checkpointing Times: https://pytorch.org/blog/reducing-checkpointing-times/
9. NVIDIA: S3-compatible AI storage: https://blogs.nvidia.com/blog/s3-compatible-ai-storage/
10. NVIDIA cuObject, release notes: https://docs.nvidia.com/gpudirect-storage/cuobject/cuobject-server-release-notes/index.html
11. VAST Data: Context Memory for Agentic AI: https://www.vastdata.com/press-releases/vast-data-brings-context-memory-to-agentic-ai-bluefield-4
12. Marvell: Bravera SC6 PCIe Gen6 NVMe: https://www.marvell.com/blogs/marvell-bravera-sc6-ssd-controller-pcie-gen6-nvme.html
13. Marvell: Structera S and CXL switching: https://www.marvell.com/blogs/structera-s-scaling-the-ai-memory-wall-with-cxl-switching.html
14. Marvell + SK hynix CXL memory: https://www.marvell.com/blogs/accelerating-ai-infrastructure-marvell-structera-sk-hynix-cxl-memory.html
Автор: Александр Иванов
Добавить комментарий
Комментариев пока нет